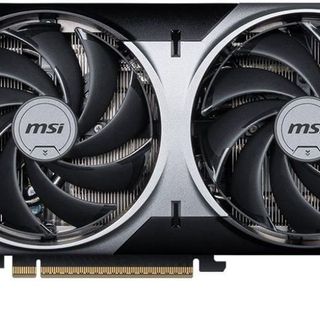
Msi GeForce RTX 5070 Ventus 2X OC 12GB
- Dostępność
- Producent
- MSI
- Chipset
- GeForce RTX 5070
- Producent chipsetu
- Nvidia
- Seria
- GeForce - inne
- RAM
- 12GB (GDDR7)
- Szyna pamięci
- 192bit
- Prędkość pamięci
- 28000 MHz
- Rdzenie CUDA
- 6144
- TBP
- 250 W
- Interfejs
- PCI-Express 5.0 x16
- Wyjścia
- HDMI, DisplayPort
- Zasilanie
- 1x 16-pin
- Minimalny zasilacz
- -
- Długość karty
- -
- Chłodzenie
- Aktywne
- Maks. rozdzielczość
- 7680 x 4320
- Standardy
- Ray Tracing
Wydajność Wysoka półka
Szybszy niż 89% kart dostępnych dziś w sklepach (10. miejsce na 83).
Co kupić zamiast
Układy sąsiadujące w rankingu „Wydajność w grach” z najtańszą dostępną ofertą.
Szybsze
- GeForce RTX 5070 Ti+12,7% grydroższy o 950 zł4699 złnajtaniej w Media Expert
Wolniejsze, ale tańsze?
- Radeon RX 9070 XT-6,1% grytańszy o 700 zł3049 złnajtaniej w x-kom
- GeForce RTX 4070-6,3% grydroższy o 650 zł4399 złnajtaniej w x-kom
AI lokalnie
Czy GeForce RTX 5070 nadaje się do uruchamiania modeli językowych na własnym komputerze (Ollama, LM Studio, llama.cpp). Większe modele i zestawy z dwiema kartami policzysz w kalkulatorze karty do AI.
W całości na karcie zmieścisz modele do 14B, na przykład Qwen3 14B (około 54 tokenów na sekundę). Większe modele uruchomisz na dwóch kartach albo z częścią modelu w pamięci RAM, wtedy wolniej.
| Model | Do czego | Potrzebuje | Mieści się | Szacowane tok/s |
|---|---|---|---|---|
| Llama 3.2 3BQ4_K_M | agenci i narzędzia | 3 GB | tak | 250bardzo szybko |
| Qwen3 8BQ4_K_M | rozumowanie, agenci i narzędzia | 6.3 GB | tak | 96bardzo szybko |
| Gemma 4 12BQ4_K_M | rozumowanie, agenci i narzędzia, rozumie obrazy | 9.1 GB | tak | 67bardzo szybko |
| Qwen3 14BQ4_K_M | rozumowanie, agenci i narzędzia | 10.5 GB | tak | 54płynnie |
| gpt-oss 20BMXFP4, MoE | rozumowanie, agenci i narzędzia | 15 GB | nie | brak |
| Qwen3.6 27BQ4_K_M | rozumowanie, agenci i narzędzia, rozumie obrazy | 20.3 GB | nie | brak |
| Gemma 4 31BQ4_K_M | rozumowanie, agenci i narzędzia, rozumie obrazy | 21.4 GB | nie | brak |
| Qwen3.6 35BQ4_K_M, MoE | rozumowanie, agenci i narzędzia, rozumie obrazy | 25 GB | nie | brak |
| Llama 3.3 70BQ4_K_M | agenci i narzędzia | 44.9 GB | nie | brak |
| gpt-oss 120BMXFP4, MoE | rozumowanie, agenci i narzędzia | 66.1 GB | nie | brak |
Liczby dla modeli to szacunek: generowanie tokenów jest ograniczone przepustowością pamięci, więc skaluje się odwrotnie do rozmiaru modelu. Model, który nie mieści się w VRAM, działa z pamięci RAM komputera kilkukrotnie wolniej. Pomiary 7B pochodzą z tabel społeczności llama.cpp.
Pytania o AI na tej karcie
Czy GeForce RTX 5070 nadaje się do lokalnego AI?
W całości na karcie zmieścisz modele do 14B, na przykład Qwen3 14B (około 54 tokenów na sekundę). Większe modele uruchomisz na dwóch kartach albo z częścią modelu w pamięci RAM, wtedy wolniej. Model 7B generuje na tej karcie około 128 tokenów na sekundę (pomiar llama.cpp).
Jaki model LLM zmieści się na 12 GB VRAM?
Największy z popularnych modeli, który mieści się w całości na GeForce RTX 5070 (12 GB), to Qwen3 14B w kwantyzacji Q4_K_M, potrzebujący około 10.5 GB pamięci. Mniejsze modele (3B, 8B, 12B, 14B) działają z zapasem na kontekst.
Dlaczego przepustowość pamięci GeForce RTX 5070 ma znaczenie dla AI?
Generowanie każdego tokena wymaga odczytania całego modelu z pamięci karty, więc szybkość odpowiedzi zależy wprost od przepustowości (672 GB/s dla tego układu). Większy model to więcej bajtów na token i proporcjonalnie mniej tokenów na sekundę.
Wyniki syntetyczne dla układu GeForce RTX 5070: PassMark, Blender Open Data (mediana wyników użytkowników) i llama.cpp. Miejsca w rankingu liczymy wśród układów konsumenckich mających dziś co najmniej jedną ofertę w monitorowanych sklepach. Konkretne gry i programy mogą układać się inaczej.
Ceny w sklepach
| Sklep | Cena | Dostępność | Akcje |
|---|---|---|---|
| Brak ofert dla tego produktu. | |||
Opinie
Masz ten produkt?
Oceń Msi GeForce RTX 5070 Ventus 2X OC 12GB i pomóż innym w wyborze!
Opinie użytkowników (0)
Nikt nie ocenił jeszcze tego produktu. Masz go u siebie? Napisz pierwszą opinię.